Qué es un LLM y cómo funciona por dentro
Olvídate de la magia negra. Te explicamos qué es un LLM y cómo funciona por dentro con datos reales, arquitectura Transformer y el impacto que tiene en tu forma

Isabel A.M.
- 📋 Lo esencial
- 📑 En este artículo
- ❓ El problema real: La trampa de la antropomorfización
- 💡 La solución: Qué es un LLM y cómo funciona por dentro
- 🗺️ El mapa del algoritmo: Anatomía matemática de un Transformer
- Paso 1: Tokenización y Embedding
- Paso 2: El mecanismo de auto-atención (Self-Attention)
- Paso 3: Generación probabilística (Sampling)
- 🛠️ Entrenamiento y refinamiento: De devorar internet a hablar con humanos
- ¿Listo para pasar de teoría a práctica?
- ⚠️ Errores comunes al interactuar con un LLM
- ❓ Preguntas frecuentes
- ¿Qué es un LLM y cómo funciona por dentro cuando comete una alucinación?
- ¿Por qué los modelos de lenguaje fallan tanto en matemáticas básicas?
- ¿Cuánta memoria consume un Transformer al procesar un temario largo?
- ¿Es posible que un LLM aprenda cosas nuevas mientras chateo con él?
- ¿Qué diferencia real hay entre el procesamiento de tokens y leer palabras?
- ¿Listo para pasar de teoría a práctica?
Estás delante de la pantalla a las dos de la mañana, le pides a una Inteligencia Artificial que te resuma las 40 páginas de Derecho Administrativo y el sistema te escupe un esquema perfecto en cuatro segundos. Parece telepatía o magia negra, pero detrás de esa interfaz limpia no hay una mente humana pensando, sino miles de millones de operaciones matemáticas corriendo sobre silicio. Para dejar de usar estas herramientas como un mono con una metralleta y empezar a dominarlas de verdad, necesitas entender qué es un LLM y cómo funciona por dentro. En Aprueba con IA estamos obsesionados con destripar los algoritmos para ponerlos a tu servicio, desnudando la tecnología para que entiendas la ingeniería real que hay detrás de cada respuesta.
📋 Lo esencial
| Definición clave | Un LLM es un modelo estadístico gigante que predice la siguiente palabra más probable en un texto. |
| Arquitectura base | Se basan en redes de tipo Transformer, utilizando mecanismos de atención para procesar contextos largos. |
| La unidad mínima | No leen letras ni palabras completas, procesan fragmentos de texto llamados tokens mediante vectores numéricos. |
| Fases de creación | El proceso requiere un preentrenamiento masivo de datos seguido de un ajuste fino o alineación humana (RLHF). |
| Utilidad real | Comprender su funcionamiento matemático permite estructurar prompts avanzados para evitar alucinaciones. |
❓ El problema real: La trampa de la antropomorfización
El 84 % de los estudiantes que usan inteligencia artificial asumen erróneamente que el sistema razona de forma similar a un cerebro humano. Esta tendencia a otorgar cualidades humanas a un software provoca que confiemos a ciegas en datos inventados y estructuremos peticiones totalmente ineficientes. Los modelos de lenguaje no entienden conceptos, solo calculan probabilidades estadísticas basadas en patrones de texto.
Cuando hablas con ChatGPT, Claude o Gemini, es extremadamente fácil caer en el autoengaño de pensar que hay «alguien» al otro lado del cable. Como el texto fluye de forma natural, asumes que el sistema posee comprensión conceptual, memoria reflexiva y sentido de la verdad. Las aproximaciones ingenuas al estudio con inteligencia artificial ignoran que estos sistemas carecen de un modelo del mundo real. No saben qué es la gravedad, ni lo que dolió la Guerra Civil, ni por qué te juegas la vida en tu próximo examen. Solo conocen cómo se relacionan las palabras que describen esos fenómenos en miles de millones de páginas web. Esta desconexión absoluta con la realidad empírica es la que genera distorsiones cognitivas en el usuario, quien confunde la elocuencia sintáctica con la veracidad factual.
Tratar a una máquina como si fuera un profesor particular humano te lleva directo al fracaso académico. Le pides cosas como «piensa bien la respuesta» o «sé sincero si no lo sabes», frases que semánticamente no significan nada para una red neuronal. Las técnicas de estudio pasivo aplicadas a la IA, como pedirle resúmenes directos sin verificar las fuentes oficiales, son una pérdida de tiempo absoluta. Ahí lo dejo. Si no comprendes que estás ante un software de predicción numérica, terminarás memorizando alucinaciones bien escritas y repitiendo datos erróneos frente al tribunal de tu oposición. Para evitar esto, es fundamental entender los sesgos de automatización analizados en los marcos de competencias digitales del Boletín Oficial del Estado (BOE), los cuales insisten en el desarrollo del pensamiento crítico frente a sistemas algorítmicos cerrados.
La psicología del aprendizaje advierte que delegar la síntesis de textos complejos en una entidad matemática sin supervisión debilita los procesos de codificación en la memoria a largo plazo. Al no realizar el esfuerzo metabólico de desgranar el temario, el cerebro procesa la información de forma superficial. Además, la tendencia a creer que el sistema opera con intencionalidad pedagógica limita nuestra capacidad para auditar los resultados, convirtiendo al estudiante en un receptor pasivo de datos probabilísticos que bien podrían estar completamente desactualizados o sesgados según el corpus de entrenamiento original.
💡 La solución: Qué es un LLM y cómo funciona por dentro
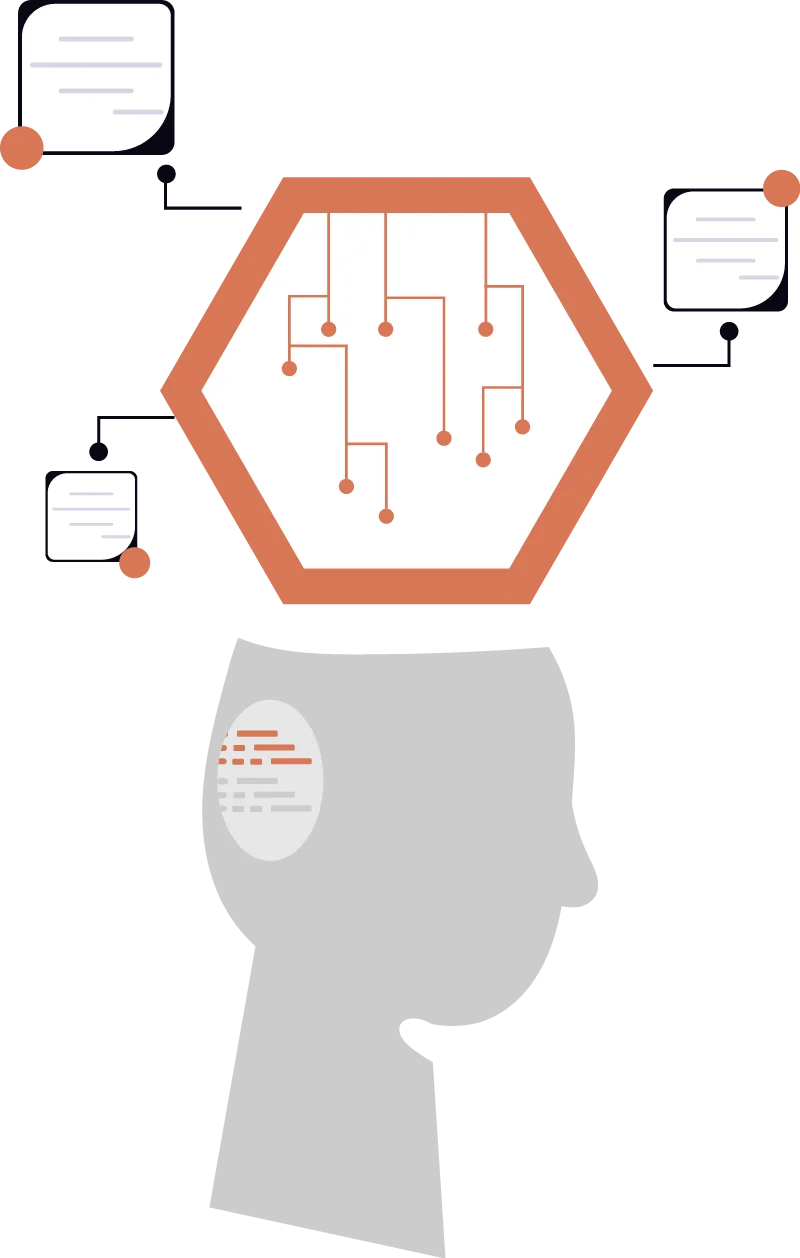
Un LLM (Large Language Model) es una arquitectura de red neuronal profunda optimizada para procesar, comprender y generar texto secuencial mediante la asignación de valores numéricos a fragmentos de palabras. Su núcleo operativo consiste en determinar matemáticamente qué carácter o elemento lingüístico debe aparecer a continuación dado un bloque de texto inicial.
Para desmitificar el proceso, piensa en el autocompletado de tu teléfono móvil, pero multiplicado por varios billones de dimensiones físicas y lógicas. Si escribes «perro ladrador,», tu teclado probablemente te sugiera «poco». ¿Por qué? Porque estadísticamente ha visto esa secuencia de caracteres miles de veces en tu historial o en el corpus del idioma. Un Gran Modelo de Lenguaje hace exactamente lo mismo, pero evaluando el contexto completo de tu prompt y cruzándolo con una matriz gigantesca de parámetros numéricos que representan el conocimiento acumulado de internet. No hay una chispa de genialidad biológica, sino una inmensa infraestructura de servidores procesando tensores matemáticos a la velocidad de la luz.
Cuando nos preguntamos qué es un LLM y cómo funciona por dentro, la palabra clave es parámetro. Los parámetros son los pesos o coeficientes numéricos que determinan la fuerza de la conexión entre los nodos de la red neuronal. Un modelo como GPT-4 cuenta con más de un billón de estos coeficientes. Al ingresar un texto, este se transforma en números, viaja a través de esa maraña de billones de conexiones y produce una distribución de probabilidad sobre todas las palabras posibles del vocabulario. El sistema elige una, la añade al texto y vuelve a empezar el bucle para la siguiente palabra. Este proceso iterativo transforma variables abstractas en respuestas coherentes estructuradas bajo estrictas reglas de distribución estadística.
Esta naturaleza matemática implica que el modelo es radicalmente dependiente de la calidad de sus datos de origen. Si un concepto no está ampliamente representado en los repositorios digitales indexados durante su creación, la red rellenará el vacío mediante interpolación estadística, generando secuencias formalmente válidas pero conceptualmente vacías. Por ello, la ingeniería de instrucciones o prompting no consiste en «hablarle» a la máquina, sino en restringir matemáticamente el espacio de búsqueda de la red para forzarla a seleccionar los vectores semánticos correctos dentro de su gigantesca matriz de conocimiento latente.
🗺️ El mapa del algoritmo: Anatomía matemática de un Transformer
La arquitectura Transformer, introducida por investigadores de Google en el año 2017, es el motor técnico que permite a los LLM procesar textos masivos de forma paralela y entender el contexto de las palabras. Su gran innovación es el mecanismo de auto-atención, que calcula la relación de cada palabra con todas las demás dentro de una misma frase.
Antes de los Transformers, las inteligencias artificiales procesaban el texto de izquierda a derecha, palabra por palabra. Si la frase era muy larga, para cuando el sistema llegaba al final ya se había «olvidado» del principio. Estudiar un temario complejo con esa tecnología era inviable. El Transformer cambió las reglas del juego al permitir que todo el texto se analice simultáneamente, asignando recursos de procesamiento a las partes de la secuencia que guardan mayor relevancia entre sí. Esto revolucionó la lingüística computacional y sentó las bases para el procesamiento de documentos masivos en tiempo récord.
Paso 1: Tokenización y Embedding
El primer paso del proceso consiste en romper el texto introducido por el usuario en unidades mínimas llamadas tokens. Un token no equivale necesariamente a una palabra; a menudo es una sílaba o un fragmento de caracteres comunes. Por ejemplo, la palabra «anticonstitucionalmente» puede dividirse en tres o cuatro tokens distintos. Una vez fragmentados, cada token se traduce en un vector: una lista de miles de números que definen su significado semántico en un espacio multidimensional. Los tokens con significados parecidos o que se usan en contextos similares se sitúan matemáticamente «cerca» los unos de los otros en este mapa vectorial, permitiendo operaciones geométricas complejas para deducir sinonimias y relaciones conceptuales profundas.
Paso 2: El mecanismo de auto-atención (Self-Attention)
Aquí ocurre la magia matemática. Cuando el modelo procesa la palabra «banco», necesita saber si te refieres a una entidad financiera o a un asiento de madera en un parque. El mecanismo de atención analiza el resto de los tokens de la frase. Si detecta palabras como «dinero», «interés» o «cuenta», el vector del token «banco» se modifica dinámicamente en tiempo de ejecución para cargarse de significado financiero. Este proceso se repite a lo largo de decenas de capas neuronales, refinando de forma matemática ultraprecisa el contexto exacto de tu consulta. De este modo, la red pondera la importancia relativa de cada elemento gramatical dentro del flujo de la oración.
| Componente | Función Principal por Dentro | Impacto en el Usuario |
|---|---|---|
| Tokenizador | Traduce texto plano a índices numéricos comprensibles por la máquina. | Determina el consumo de la ventana de contexto de tu prompt. |
| Capas de Atención | Calculan el peso relativo y las conexiones semánticas entre palabras lejanas. | Permite al modelo entender pronombres, ironías y contextos complejos de estudio. |
| Matriz de Pesos | Almacena los billones de coeficientes aprendidos durante el entrenamiento. | Es el «conocimiento estático» del modelo; determina su inteligencia base. |
Paso 3: Generación probabilística (Sampling)
Una vez calculado el contexto, la capa de salida del LLM genera una lista de puntuaciones para cada palabra de su vocabulario (que suele rondar los 50.000 o 100.000 términos). Estas puntuaciones se transforman en probabilidades mediante una función matemática llamada Softmax. Si la temperatura del modelo está configurada a cero, el sistema elegirá siempre la palabra con mayor probabilidad absoluta, volviéndose predecible y rígido. Si subes la temperatura, el sistema se arriesga a elegir palabras con menor puntuación, lo que interpretamos externamente como «creatividad» o fluidez literaria. Este equilibrio es vital para adaptar el comportamiento del sistema a tareas científicas o artísticas.
🛠️ Entrenamiento y refinamiento: De devorar internet a hablar con humanos
El desarrollo de un LLM comercial consta de dos fases críticas: el preentrenamiento autosupervisado, donde la red aprende la estructura del lenguaje devorando petabytes de texto, y la alineación mediante refuerzo humano (RLHF), que transforma un predictor salvaje de palabras en un asistente útil y seguro.
Si te viene bien, aquí tienes el planificador de oposiciones.
En la primera fase, el modelo es simplemente un lector compulsivo. Se le introducen textos extraídos de Wikipedia, libros digitalizados, repositorios de código y foros de internet. Su única tarea en este punto es jugar a adivinar la siguiente palabra oculta. Si la red falla, el algoritmo de retropropagación ajusta levemente los billones de parámetros para que la próxima vez el error sea menor. Al repetir este proceso trillones de veces, el modelo desarrolla de forma interna una comprensión profunda de la gramática, la lógica, la programación e incluso destellos de sentido común. No obstante, en esta etapa el sistema carece de filtros morales o directrices operativas claras.
Sin bien este modelo preentrenado es superpotente, resulta inútil para el usuario común. Si le escribes «Hazme un examen de la Unión Europea», el modelo bruto podría limitarse a completar el texto escribiendo «y puntúalo sobre diez puntos, usando folios en blanco», porque estadísticamente es como continuaría una frase en un documento escolar. Para solucionar esto, las empresas aplican el Ajuste Fino Instructivo y el Aprendizaje por Refuerzo con Retroalimentación Humana (RLHF). Equipos de ingenieros y educadores evalúan miles de respuestas, premiando las que contestan correctamente a las órdenes y castigando las respuestas groseras, incoherentes o peligrosas. Esta fase de alineación es la que dota al software de su interfaz conversacional característica.
Estudios publicados por ministerios de innovación tecnológica subrayan que la alineación no incrementa el conocimiento base del modelo, sino que actúa como una máscara de usabilidad. El verdadero potencial cognitivo abstracto reside enteramente en la fase de preentrenamiento masivo, mientras que el ajuste fino simplemente canaliza ese conocimiento latente hacia formatos que los humanos consideramos aceptables, corteses y estructurados en forma de diálogo interactivo.
¿Listo para pasar de teoría a práctica?
Dominar la teoría de la IA está genial, pero la diferencia real en tus notas se nota cuando la pones a trabajar para ti. En Aprueba con IA hemos diseñado herramientas específicas que aprovechan al máximo los LLM para optimizar tus horas de estudio.
⚠️ Errores comunes al interactuar con un LLM
Los usuarios inexpertos cometen el error de tratar a los modelos de lenguaje como repositorios de datos exactos o motores de búsqueda en tiempo real. Esta falta de criterio técnico provoca que las alucinaciones del sistema pasen desapercibidas y arruinen la calidad del material de estudio generado.
El error más sangriento es confiar en la precisión matemática de un modelo sin herramientas externas. Como los LLM operan estimando probabilidades de tokens, realizar operaciones aritméticas complejas o contar caracteres exactos se les da fatal por diseño por dentro. Si le pides que cuente las letras «e» en un párrafo largo, fallará casi seguro, porque la red procesa tokens (bloques de letras) y no tiene un cursor visual que examine letra por letra como haría un humano. Esta limitación estructural suele sorprender a los estudiantes que intentan resolver problemas de lógica pura o programación avanzada sin activar módulos de ejecución de código integrados.
Otro fallo garrafal es no acotar el contexto. Si le dejas barra libre para que te explique un concepto de oposiciones sin proporcionarle un marco documental, el modelo rellenará los huecos informáticos con los tokens estadísticamente más atractivos, aunque sean falsos. Para estudiar de verdad, necesitas nutrir al sistema con textos específicos y ordenarle que se ciña estrictamente a ellos. De lo contrario, el software priorizará la fluidez estilística sobre la fidelidad histórica o jurídica, destruyendo el valor de tus resúmenes.
Para mitigar estos riesgos de forma drástica, las autoridades en educación digital del Ministerio de Educación y Formación Profesional aconsejan implementar dinámicas de verificación cruzada. Nunca debe darse por buena una fecha, una ley o un dato estadístico generado por IA sin contrastarlo simultáneamente con la fuente legislativa primaria o los manuales de referencia oficiales validados por comités de expertos independientes.
Para exprimir estas tecnologías sin caer en sus trampas, lo ideal es combinar tu flujo de estudio con recursos interactivos validados. Por ejemplo, puedes usar la Suite de herramientas IA para estudiar de Aprueba con IA para procesar tus apuntes de forma controlada, asegurándote de que el modelo no se desvíe del temario oficial. Si notas el cerebro saturado de tanta densidad técnica, puedes pasarte por nuestro Arcade de minijuegos para repasar jugando, una forma brutal de asentar conceptos sin el estrés de la pantalla de chat en blanco. Y si tu objetivo es medir tu nivel real de cara al acceso universitario, no dejes tu futuro al azar de un prompt genérico; utiliza nuestra calculadora en la sección de Notas de corte de selectividad para diseñar tu estrategia de estudio con datos reales del Ministerio de Educación y Formación Profesional, garantizando que cada hora de hincar los codos sume décimas reales en tu expediente.
❓ Preguntas frecuentes
¿Qué es un LLM y cómo funciona por dentro cuando comete una alucinación?
Una alucinación ocurre cuando el modelo genera una secuencia de palabras que es gramaticalmente perfecta y lógicamente coherente, pero tácticamente falsa en el mundo real. Sucede porque el sistema prioriza la probabilidad estadística de la combinación de tokens sobre la veracidad empírica de los datos. El algoritmo simplemente encadena los elementos numéricos de mayor peso relativo sin poseer un mecanismo interno de verificación factual.
¿Por qué los modelos de lenguaje fallan tanto en matemáticas básicas?
Porque no ejecutan un algoritmo de cálculo aritmético interno, sino que predicen los números como si fueran palabras. Si el modelo no ha visto la operación exacta miles de veces durante su preentrenamiento, intentará adivinar el resultado basándose en patrones visuales de los tokens numéricos. Carecen de una unidad lógica de procesamiento matemático puro, dependiendo por completo de correlaciones textuales previas.
¿Cuánta memoria consume un Transformer al procesar un temario largo?
El consumo de memoria crece de forma cuadrática respecto a la longitud del texto de entrada debido al mecanismo de atención. Cada palabra extra añadida al prompt obliga al sistema a calcular relaciones matemáticas con absolutamente todos los tokens previos, saturando el hardware si superas su ventana de contexto. Esta restricción computacional exige optimizaciones masivas en el diseño de las arquitecturas de servidores modernas.
¿Es posible que un LLM aprenda cosas nuevas mientras chateo con él?
No, los pesos y parámetros numéricos de la red neuronal son completamente estáticos tras su fase de entrenamiento. Lo que interpretas como aprendizaje es solo la gestión de la ventana de contexto a corto plazo, donde el modelo utiliza los mensajes anteriores del chat para ajustar la probabilidad de sus próximas respuestas. Una vez cerrada la sesión conversacional, esa información contextual se borra definitivamente del sistema inmediato.
¿Qué diferencia real hay entre el procesamiento de tokens y leer palabras?
La tokenización optimiza la eficiencia del software. Al romper las palabras en fragmentos comunes, el modelo puede manejar un vocabulario matemático mucho más pequeño y entender raíces lingüísticas compartidas entre idiomas sin necesidad de almacenar diccionarios enteros de millones de palabras compuestas. Esto permite optimizar el espacio en memoria y acelerar los cálculos de probabilidad en las capas internas de la red.
Entender a fondo la infraestructura digital que manejas a diario no es solo curiosidad friki; es la única ventaja competitiva real que te queda en un mundo saturado de automatizaciones baratas. Cuando asimilas que la inteligencia artificial es un gigantesco juego de dados estadístico optimizado al milímetro, dejas de frustrarte por sus errores y empiezas a diseñar prompts como un ingeniero de sistemas. La próxima vez que uses Aprueba con IA para desgranar un tema complejo, fíjate en cómo responde la máquina según el contexto que le marcas. ¿Vas a seguir usando los modelos de lenguaje como un buscador de Google glorificado o vas a empezar a hackear tu método de estudio desde los cimientos matemáticos de la tecnología?
¿Listo para pasar de teoría a práctica?
No dejes tu preparación en manos de la improvisación estadística. Entra en nuestra plataforma, toma el control de los algoritmos y diseña tu hoja de ruta académica con herramientas optimizadas por expertos en pedagogía e inteligencia artificial.
Ponte a prueba
Convierte este tema en un test con IA
Sube tus apuntes o pega el temario y la IA te genera un test personalizado en un minuto. Gratis.
Crear mi test gratisSin tarjeta de crédito.
Sigue leyendo
La organización territorial del Estado
Domina la estructura administrativa del Estado con esta guía profunda. Analizamos la estructura de CCAA, provi
Oftalmología MIR: La guía definitiva para dominar la especialidad con IA
Descubre cómo abordar esta rama visual para el examen MIR. Analizamos los temas más rentables y cómo la IA pue
Derechos y deberes fundamentales: su garantía y suspensión
El Título I de la Constitución es el bloque más preguntado en cualquier oposición. Descubre cómo dominar los d
Herramientas y guías